
Hai sentito parlare di Googlebot e vuoi comprendere meglio di cosa si tratta? In questa guida completa, tratta dalla documentazione ufficiale e dedicata a chi vuole diventare SEO specialist, ti spiego tecnicamente cos’è e come funziona.
Indice dei contenuti:
- Che cos’è Googlebot
- Crawler di Google: spider, bot e varianti di Googlebot
- Elenco user-agent di Google
- Ogni quanto passa Googlebot
- Limiti e caratteristiche di Googlebot
- Come impedire a Googlebot di visitare il proprio sito
- Problemi con spammer e altri user-agent
- Ottimizzazione tecnica del sito per Googlebot e il crawling
- Monitorare e analizzare il comportamento del web crawler di Google
- Domande frequenti
- Conoscere Googlebot per ottimizzare il Crawl Budget per la SEO
Che cos’è Googlebot

Googlebot è un software che identifica il web crawler di Google. Per la precisione identifica due diversi tipi di crawler:
- Un crawler desktop che simula un utente da dispositivo desktop;
- Un crawler mobile che simula un utente da dispositivo mobile.
Il 1° si occupa di accedere ai contenuti web in modalità “desktop-browser”, mentre il 2° si occupa di effettuare il crawling dei contenuti destinati agli utenti mobile.
Entrambi i bot rispettano però il medesimo token di prodotto (token dello user-agent) nel file robots.txt, quindi non possiamo scegliere selettivamente come target Googlebot Smartphone o Desktop tramite il robots.txt.
Se hai un sito convertito in sito con priorità ai contenuti per dispositivi mobili su Google (Mobile-first indexing enabled), la maggior parte delle scansioni viene effettuata tramite Googlebot Smartphone, mentre una piccola parte continua ad essere svolta con il crawler desktop.
Per i siti che invece non sono stati ancora convertiti, la maggior parte delle scansioni continua ad essere svolta attraverso il crawler desktop.
In entrambi i casi, il crawler di minoranza effettua la scansione soltanto degli URL già sottoposti a scansione dal crawler di maggioranza.
Probabilmente il tuo sito sarà sottoposto a scansione da entrambi i crawler (Desktop e Smartphone) e puoi identificare il sottotipo di Googlebot esaminando la stringa dello user-agent nella richiesta presente nei file log del tuo server.
Crawler di Google: spider, bot e varianti di Googlebot

Per capire davvero che cosa rappresenta, conviene partire da un concetto più ampio: quello di crawler, chiamato anche Bot o Spider.
Sono programmi automatizzati che i motori di ricerca come Google utilizzano per scansionare la rete e individuare nuove pagine da inserire nei propri sistemi.
Oltre a Googlebot esistono altri Crawler di Google, ognuno con un compito specifico:
- analizzare le immagini;
- raccogliere contenuti dalle news;
- interpretare i video;
- valutare la qualità degli annunci pubblicitari.
Tutti questi bot lavorano insieme e alimentano l’indice di Google, garantendo che i contenuti vengano organizzati e resi disponibili in SERP.
Conoscere questa distinzione è utile perché:
- ti aiuta a interpretare correttamente i log del server, dove potresti trovare user-agent differenti;
- ti permette di capire che Googlebot è il bot “principale”, ma non l’unico robot di Google impegnato a esplorare il web.
Come funziona Googlebot: Elenco user-agent di Google

Nella tabella che segue vengono indicati i robot che Google utilizza per vari prodotti e servizi:
| Crawler | User agent | Stringa completa dello user-agent |
|---|---|---|
| APIs-Google |
| APIs-Google (+https://developers.google.com/webmasters/APIs-Google.html) |
| AdSense |
| Mediapartners-Google(Analizza i contenuti AdSense) |
| AdsBot Mobile Web Android |
| Mozilla/5.0 (Linux; Android 5.0; SM-G920A) AppleWebKit (KHTML, like Gecko) Chrome Mobile Safari (compatible; AdsBot-Google-Mobile; +http://www.google.com/mobile/adsbot.html)(Verifica la qualità dell’annuncio nella pagina web Android) |
| AdsBot Mobile Web |
| Mozilla/5.0 (iPhone; CPU iPhone OS 9_1 like Mac OS X) AppleWebKit/601.1.46 (KHTML, like Gecko) Version/9.0 Mobile/13B143 Safari/601.1 (compatible; AdsBot-Google-Mobile; +http://www.google.com/mobile/adsbot.html)(Verifica la qualità dell’annuncio nella pagina web dell’iPhone) |
| AdsBot |
| AdsBot-Google (+http://www.google.com/adsbot.html)(Verifica la qualità dell’annuncio nella pagina web per desktop) |
| Googlebot Immagini |
| Googlebot-Image/1.0(Analizza le immagini) |
| Googlebot News |
| Googlebot-News |
| Googlebot Video |
| Googlebot-Video/1.0 |
| Googlebot (Desktop) |
|
o (utilizzato raramente):
(Analizza le pagine web) |
| Googlebot (Smartphone) |
| Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2272.96 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)(Analizza le pagine web per i dispositivi mobile) |
| Mobile AdSense |
| (Vari tipi di dispositivi mobili) (compatible; Mediapartners-Google/2.1; +http://www.google.com/bot.html) |
| Mobile Apps Android |
| AdsBot-Google-Mobile-Apps(Verifica la qualità dell’annuncio nella pagina per app Android. Segue le regole dei robot AdsBot-Google.) |
Come mostrato nella tabella, alcuni bot di Google hanno più di uno user agent, ma devi utilizzare un solo token corrispondente per poter applicare una regola.
Il token dello user-agent viene usato nella riga User-agent del file robots.txt in modo che ci sia corrispondenza con un tipo di crawler durante la scrittura delle regole di scansione per il tuo sito.
La stringa completa dello user-agent è una descrizione completa del crawler principale che viene mostrata nella richiesta e nei log web.
Questo elenco non è completo, ma include la maggior parte degli spider di Google che puoi vedere analizzando il log del tuo sito web.
Questi valori possono essere oggetto di spoofing. Se devi verificare che il visitatore è realmente Googlebot, esegui una ricerca DNS inversa oppure tra gli intervalli di indirizzi IP.
Frequenza di Scansione: ogni quanto passa lo spider Googlebot
Googlebot può eseguire la scansione contemporaneamente da migliaia di computer per migliorare il rendimento e seguire il ritmo di crescita del Web.
Trattandosi di un software etico, Google esegue la scansione del sito senza sovraccaricare il web server che lo ospita.
Normalmente accede alla maggioranza dei siti non più di una volta ogni pochi secondi.
In alcuni casi e per brevi periodi, tale frequenza potrebbe risultare leggermente superiore.
Inoltre, per ridurre l’utilizzo di larghezza di banda, Google esegue molte scansioni su computer vicini fisicamente ai siti che potrebbero essere sottoposti a scansione.
Di conseguenza i tuoi log potrebbero registrare visite di Google da diversi computer, tutte con lo user-agent Googlebot, ma con IP differenti.
Di solito gli indirizzi IP di Googlebot presentano la seguente classe C: 66.249.
Ricorda che l’obiettivo di Googlebot è prelevare il maggior numero di pagine del tuo sito evitando però di sovraccaricare il tuo web server.
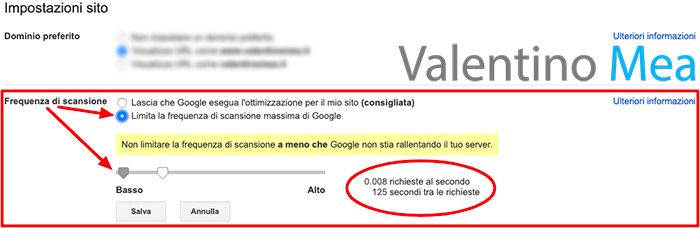
Se il tuo server è lento e non riesce a stare al passo con le richieste di scansione di Google, puoi limitare la frequenza di scansione massima tramite le impostazioni sito di Google Search Console.
Limiti tecnici e caratteristiche di Googlebot

Nonostante la sua potenza, ha comunque dei confini tecnici che è utile conoscere per evitare fraintendimenti e per ottimizzare al meglio il tuo sito.
Questi limiti non devono essere visti come ostacoli, ma come linee guida che aiutano a comprendere il reale comportamento di Googlebot durante la scansione delle pagine.
In particolare:
- Elabora i primi 15 MB del codice HTML di una pagina. Tutto ciò che si trova oltre questa soglia non viene preso in considerazione.
- Le risorse collegate, come immagini, file CSS, JavaScript o video, vengono recuperate separatamente, e ognuna è soggetta ai propri limiti di dimensione.
Per chi gestisce un sito, questo significa che la parte più importante dei contenuti deve trovarsi all’interno dei primi megabyte del codice.
Struttura, titoli e testi principali dovrebbero comparire all’inizio della pagina, così da garantire che Google riesca a interpretarli e a valorizzarli nei risultati di ricerca.
Conoscere questi aspetti tecnici ti permette di presentare al meglio i contenuti fondamentali del tuo progetto e di ridurre il rischio che informazioni cruciali vengano trascurate.
Come impedire a Googlebot di visitare e indicizzare il proprio sito web
Risulta molto difficile tenere segreto un server web evitando di pubblicare link che rimandano a esso.
Ad esempio, non appena un utente segue un link che dal tuo server “segreto” rimanda a un altro server, il tuo URL “segreto” potrebbe essere visualizzato nel tag referrer ed essere memorizzato e pubblicato nel file log dall’altro server.
Allo stesso modo, sul Web esistono molti link obsoleti e inaccessibili.
Quando qualcuno pubblica un link sbagliato che rimanda al tuo sito o non aggiorna i link per riflettere i cambiamenti avvenuti nel tuo server, Googlebot prova a eseguire la scansione di questo link sbagliato dal tuo sito.
Se vuoi impedire che Googlebot esegua la scansione dei contenuti del tuo sito, hai a disposizione le seguenti opzioni:
- file robots.txt;
- meta tags Robots;
- intestazione http X-Robots-Tag;
- file del server web protetti da password.
Tieni sempre presente la differenza tra:
- impedire a Googlebot di eseguire la scansione di una pagina;
- impedire a Googlebot di indicizzare una pagina;
- impedire del tutto l’accesso a una pagina sia ai bot sia agli utenti.
Sono cose molto differenti che se non gestite correttamente da un consulente SEO esperto, possono provocare gravi danni al traffico organico del sito.
Problemi con spammer e altri crawler

Di tanto in tanto gli indirizzi IP utilizzati da parte di Googlebot cambiano, pertanto è normale che vi siano più richieste con il medesimo user agent da diversi IP.
Googlebot si identifica con una stringa dello user-agent, che però potrebbe essere oggetto di spoofing.
Il modo migliore per identificare gli accessi effettivamente eseguiti dal crawler di Google consiste nell’utilizzare una ricerca DNS inversa.
Tieni presente che tutti i bot dei motori di ricerca rispettano le direttive presenti nel file robots.txt, ma molti crawler e spammer non le seguono ignorandole completamente.
Ottimizzare il tuo sito per Googlebot, crawling e la ricerca di Google

Per rendere efficace la tua strategia SEO, la crawlability del sito è un prerequisito fondamentale: se le pagine non possono essere esplorate correttamente, difficilmente entreranno a far parte dei risultati di ricerca.
Curare l’architettura tecnica significa agevolare l’attività di Googlebot e aumentare le possibilità che i tuoi contenuti vengano interpretati e valorizzati.
Ecco i punti essenziali da considerare:
- Architettura del sito e link interni: una struttura logica e collegamenti ben distribuiti aiutano Google a capire le priorità delle pagine.
- Gestione del file robots.txt e dei meta tag: regole chiare e precise evitano di bloccare sezioni importanti del sito.
- Performance del sito: velocità di caricamento e server reattivo sono fattori chiave per favorire il passaggio dei crawler.
- Contenuti aggiornati: quando Googlebot scansiona un sito con frequenza, la presenza di contenuti freschi incentiva visite regolari.
Un sito tecnicamente ottimizzato non solo agevola il modo in cui Googlebot esplora e interpreta le pagine, ma crea anche le basi per una crescita stabile e duratura nei risultati di ricerca.
Monitorare e analizzare il comportamento del web crawler di Google

Sapere come Googlebot esplora il tuo sito è fondamentale per prevenire errori e ottimizzare la visibilità nei risultati di ricerca di Google.
Puoi affidarti a strumenti come Google Search Console, che forniscono dati chiari e report completi, indispensabili per una verifica accurata.
Con questo strumento puoi:
- Controllare gli errori di crawling: il rapporto “Indicizzazione delle pagine” mostra in modo chiaro problemi come errori 404, 5xx e altre criticità di scansione.
- Visualizzare come Google interpreta una pagina: lo strumento “Controllo URL” ti permette di vedere esattamente lo stato di indicizzazione di una pagina.
- Monitorare le statistiche e individuare anomalie: il rapporto sulle “statistiche di scansione” offre una panoramica su come Googlebot visita il tuo sito.
Oltre a GSC, esistono anche altri tool:
- Screaming Frog: ideale per simulare il comportamento di un crawler e identificare problemi tecnici;
- Botify: utile per analisi avanzate e siti di grandi dimensioni;
- Semrush: che combina audit tecnici con dati di posizionamento.
Integrare questi strumenti ti consente di avere una visione completa: da un lato i dati ufficiali, dall’altro un controllo indipendente che aiuta a scoprire criticità nascoste.
Domande frequenti

Quando si gestisce un progetto online è normale avere dubbi e domande ricorrenti su come garantire la massima visibilità e stabilità nel tempo.
In questa sezione abbiamo raccolto le risposte più utili e concrete ai quesiti che ci vengono posti più spesso, con particolare attenzione al ruolo di Googlebot.
Troverai chiarimenti pratici che ti aiuteranno a fare scelte consapevoli e ad affrontare con sicurezza gli aspetti tecnici che possono fare la differenza per la crescita del tuo sito.
Perché è importante configurare correttamente il file robots.txt?
Configurarlo correttamente è fondamentale perché permette di guidare i crawler dei motori di ricerca e stabilire quali sezioni del sito devono o non devono essere esplorate.
Un’impostazione errata può bloccare contenuti importanti e ridurre la visibilità nelle ricerche, mentre una gestione precisa aiuta a ottimizzare le risorse che Googlebot deve dedicare alla scansione del tuo sito.
La scansione di Googlebot aiuta i motori di ricerca a comprendere una pagina web?
Sì, è il passaggio chiave che permette ai motori di ricerca di interpretare i contenuti di una risorsa e inserirli nell’indice.
Ciò significa che Google può restituire la tua pagina in modo più accurato nella SERP, migliorando le possibilità di visibilità online.
In che modo lo spider di Google gestisce i contenuti duplicati?
Lo spider di Google gestisce i contenuti duplicati identificando le pagine simili e scegliendo quella più rilevante da mostrare nella ricerca di Google.
Ogni volta che Googlebot analizza più versioni della stessa pagina, decide quale mostrare agli utenti.
Per favorire questo processo è consigliato usare il tag canonical e impostare correttamente i reindirizzamenti 301, così da indicare chiaramente quale versione deve essere considerata principale.
Il robot di Google riesce sempre a leggere le sitemap o possono verificarsi problemi?
No, non riesce sempre a leggere correttamente le Sitemap. Possono verificarsi problemi legati a formati non validi, URL bloccati dal Robots.txt o incoerenze tra Sitemap e contenuti reali del sito.
Per evitare errori è utile controllare regolarmente con Google Search Console e assicurarsi che le sitemap includano solo pagine aggiornate e realmente accessibili.
Dove posso trovare tutti gli indirizzi IP di Googlebot pubblicati?
Google non mette a disposizione un elenco definitivo di tutti gli indirizzi IP di Googlebot, perché questi possono variare di frequente e non sarebbe un metodo affidabile per riconoscerlo.
Su Google Search Central invece viene pubblicato un elenco aggiornato degli intervalli IP del crawler associati a Googlebot, utile per configurazioni tecniche avanzate o controlli di sicurezza.
Quanto è importante avere una buona versione mobile del sito?
È decisiva: Google utilizza la versione mobile dei siti come base per l’indicizzazione.
Una buona user experience da mobile, con struttura chiara, caricamento veloce e contenuti facilmente fruibili, assicura che le pagine vengano comprese e interpretate correttamente.
Come prevenire gli errori che bloccano la scansione del sito quando Googlebot esegue il crawling?
Per ridurre i rischi e fare in modo che Googlebot dedichi le sue risorse alle pagine più utili e strategiche:
- Assicurati che il file robots.txt non blocchi sezioni importanti.
- Correggi errori di server e link rotti (404, 5xx).
- Mantieni una buona velocità di caricamento delle pagine.
- Usa reindirizzamenti 301 e tag canonical per gestire duplicati.
- Controlla regolarmente i report di Google Search Console.
Conoscere Googlebot per ottimizzare il Crawl Budget per la SEO

Il crawl budget è un concetto fondamentale nella SEO (Search Engine Optimization), rappresentando la quantità di pagine che Google è disposto a scansionare di un determinato sito web entro un certo lasso di tempo.
La scansione di Googlebot è il processo utilizzato da Google per analizzare tutte le pagine di un sito, aggiornando e arricchendo così il proprio indice.
Per massimizzare l’efficacia del crawl budget, è essenziale ottimizzare il tuo sito web, affrontando questioni come la velocità del sito, la struttura dei link, la duplicazione dei contenuti e l’efficienza generale della scansione del sito.
Questa ottimizzazione aumenta la scansione del tuo sito e garantisce che le pagine più importanti siano scansionate regolarmente e quindi più propense ad essere indicizzate nella ricerca di Google.
Vuoi maggiori informazioni su come funziona Googlebot? Scrivici nei commenti o contattaci per richiedere un’analisi approfondita e personalizzata del tuo sito web.


Ottimo articolo su Googlebot, veramente completo e soprattutto utile ai fini pratici.
Buongiorno Davide,
grazie per il feedback. Ci vediamo presto!